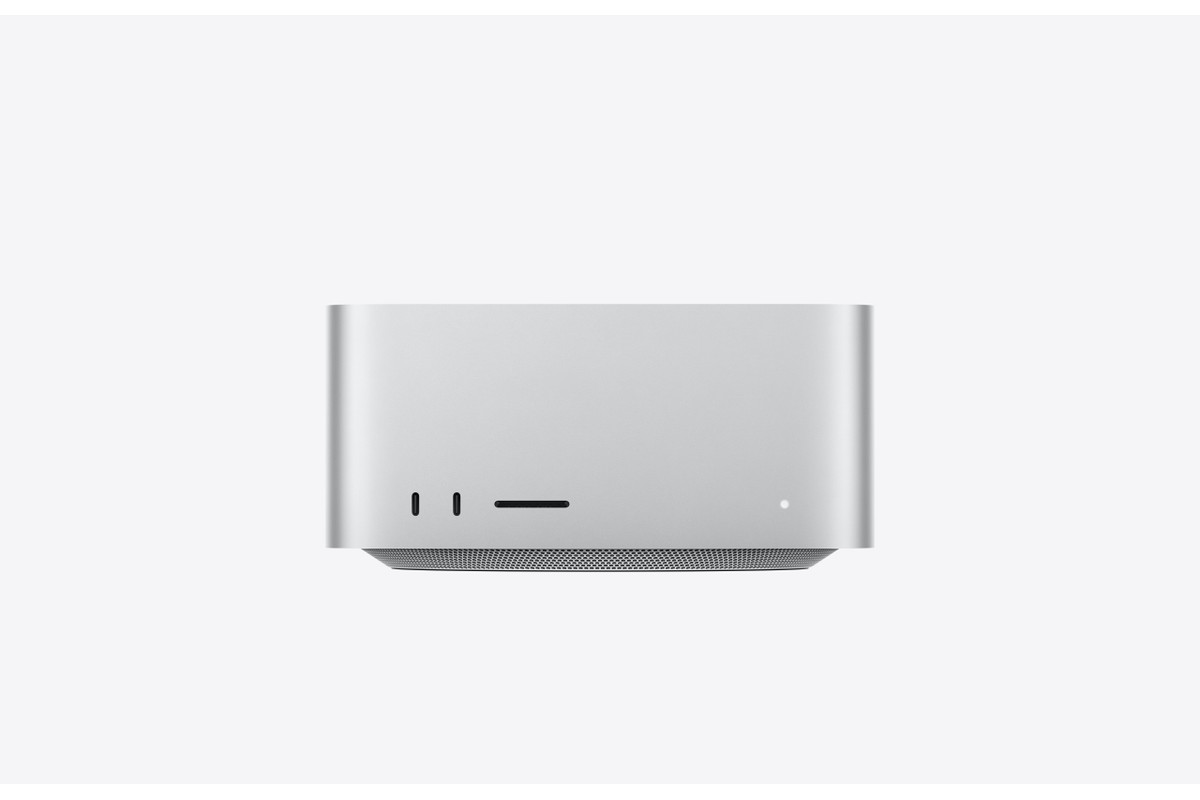
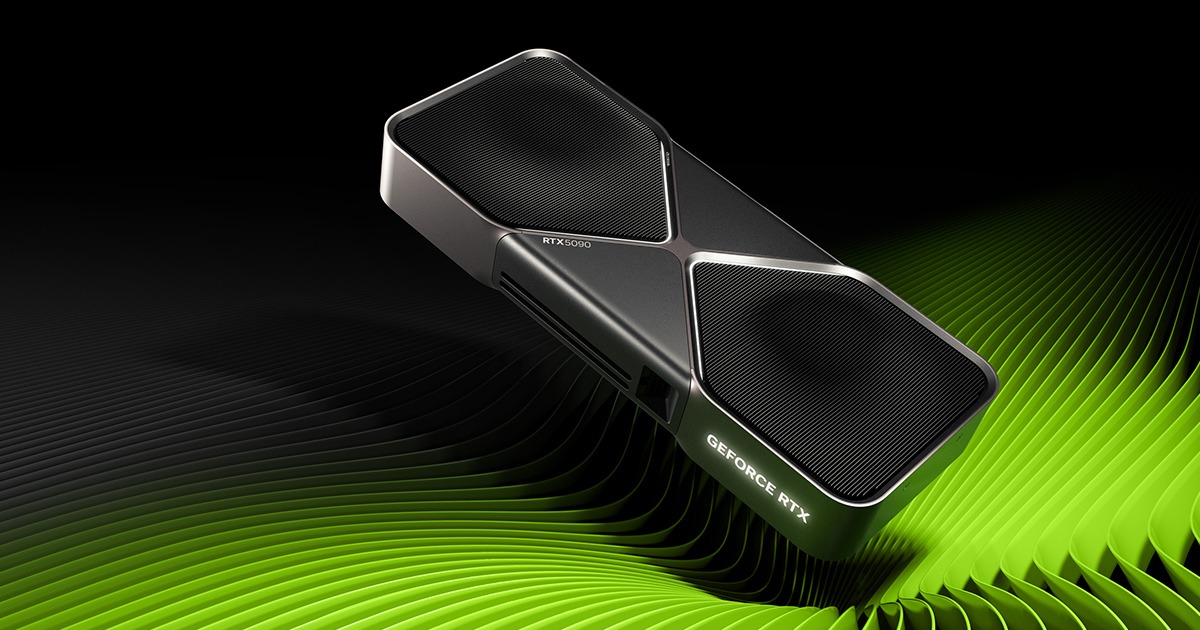
Mac mini, Mac Studio, DGX Spark / ThinkStation PGX und RTX 5090 im Vergleich: Rechenleistung, Speichergrenzen und veröffentlichte Benchmarks für lokale Sprach-, Bild- und Videomodelle.
Apple-Daten 25.10.2026LM Studio + ComfyUIVeröffentlichte Benchmarks + Speichercheck
SMALL FOOTPRINT. BIG POSSIBILITIES.
Speicher verändert die Möglichkeiten.32 GB VRAMvs.96 GB Unified
APPLE SILICON × NVIDIA BLACKWELL
✳
Geschwindigkeit und Speicherkapazität. Die RTX 5090 ist eine schnelle Option, solange der Workload in den VRAM passt. Darüber konkurrieren DGX Spark / PGX mit 128 GB und Apple Silicon: CUDA, Modellarchitektur und Speicherbandbreite entscheiden. Ein 256-GB-Studio erweitert die Kapazität über Spark hinaus.
Wie bei Apple konfigurierbar. Änderungen wirken direkt auf das Modell-Labor.
Konfiguration geprüft: Der Mac Studio mit 80 GPU-Kernen verwendet den M5 Ultra. Für die Studios sind 512 GB (Max) und 1 TB (Ultra) SSD vorausgewählt. Preisquelle für die Macs ist Apple Deutschland, inklusive MwSt. Für alle aktuell auswählbaren Kombinationen wurde der exakte Endpreis im Apple-Konfigurator abgerufen. Chip, RAM, SSD und beim Mac mini Ethernet werden berücksichtigt. 512 GB RAM beim Ultra waren beim Abruf nicht konfigurierbar; die Option ist deaktiviert.
Spark-Desktop präzisiert · 27.10.2026: Die verlinkten Geräte sind DGX Spark Founders Edition und Lenovo ThinkStation PGX mit GB10, 128 GB Unified Memory und DGX OS (Linux auf Arm). Beide verwenden einen gemeinsamen CPU-/GPU-Speicher. Über die Hersteller-Auswahl wechselst du zwischen Founders Edition (4 TB, 7.500 €) und PGX (1 TB, 5.869 €). Die Preise wurden vom Nutzer vorgegeben; die Händlerseiten waren beim Abruf nicht zugänglich. DGX-Benchmarks sind keine gesonderten Lenovo-Messungen.
Grün = größter Wert im Vergleich · keine Geschwindigkeitswertung
02 / DAS MODELL-LABOR
Welche Modelle passen in den Speicher?
Sprach-, Bild- und Videomodelle über die Schalter auswählen.
Ein Modell. Sechs Speichergrenzen.
belegt verfügbar
Wie wird das abgeschätzt?
„Passt voraussichtlich“ bestätigt die Speichergröße, nicht die Unterstützung aller Operatoren oder die erfolgreiche Ausführung. Parallel laufende Apps, Backend, Modellformat, Batchgröße und Betriebssystem können das Ergebnis ändern. Apple Unified Memory ist nicht vollständig für die GPU garantiert verfügbar. „Knapp“ gilt ab 85 % des angesetzten Budgets.
Die Größenordnung macht den Unterschied.
Alle Referenzmodelle bei der aktuellen Quantisierung und Kontextlänge.
03 / PERFORMANCE MIT KONTEXT
Gemessene Leistung. Konkrete Bedingungen.
GPU-Kerne verschiedener Architekturen lassen sich nicht direkt gegeneinander aufrechnen.
MESSUNG ≠ PROGNOSE
↗
Bandbreite als Orientierung
Für die Token-Erzeugung dichter LLMs bei Batch 1 kann Speicherbandbreite ein wichtiger Faktor sein. Das ist kein vollständiges Performance-Modell.
Apple: maximale gemeinsame Speicherbandbreite. RTX: GDDR7-Bandbreite. Reale Auslastung und Speicherzugriffe unterscheiden sich. Keine Tokens/s daraus abgeleitet.
◷
Eigene Referenzmessungen
Messwerte können für das aktuell ausgewählte Modell eingetragen werden. Konfiguration, Quantisierung und Kontext werden mit dem Wert gespeichert.
VERÖFFENTLICHTE MESSREIHEN · STAND 27.10.2026
Tokens pro Sekunde – mit Herkunft.
Originalmessungen der RTX 5090, DGX Spark GB10 und Apple-Chips. Spaltenüberschrift anklicken zum Sortieren; erneut klicken kehrt die Reihenfolge um.
EXTERNE MESSWERTE
Gemeinsamer Referenztest ergänzt: Llama 2 7B Q4_0 ist jetzt für RTX, DGX Spark und Apple vertreten (pp512 / tg128). Gleicher Test und gleiche Quantisierung, aber unterschiedliche Builds und Backends. Für Llama 3.1 8B sowie Qwen3 8B/32B sind ebenfalls alle drei Hardwarefamilien vertreten; Quantisierung und Kontext unterscheiden sich je Messreihe. M2-/M3-Ultra-Werte sind ältere Desktop-Referenzen und keine M5-Prognosen.
Welche Modell-/Hardware-Kombinationen sind belegt?
Die Anzahl zählt veröffentlichte Messpunkte, keine unabhängigen Testlabore und keine Geschwindigkeitswertung. „—“ bedeutet: kein ausreichend dokumentierter Wert übernommen. Diese Übersicht zeigt den gesamten Datensatz unabhängig von den Filtern. Apple kann eine ältere Desktop-Referenz sein; die genaue Hardware steht in der Messwerttabelle. Gleicher Modellname allein bestätigt keine identischen Testbedingungen.
Offene Lücken bleiben unter anderem Spark für Qwen3 14B, RTX für Qwen2.5-Coder 32B sowie Apple/Spark für die exakte Qwen3-30B-A3B-Instruct-2507-Version. Für gpt-oss 120B wurde kein ausreichend dokumentierter Lauf auf unserem einzelnen RTX-5090-Referenz-PC übernommen. Zwei Karten, andere Modellversionen und reine Bandbreiten-Schätzungen ersetzen diese Messungen nicht.
Generation (TG) bezeichnet erzeugte Tokens pro Sekunde; Prompt-Verarbeitung (PP) die Verarbeitung der Eingabe. Die Werte stammen aus unterschiedlichen Rechnern und Builds. Ein TG128-Test ist keine Messung bei 128K Kontext. Kontexttiefe, Promptlänge und Ausgabelänge sind unterschiedliche Angaben; die jeweilige Zeile nennt das Testprotokoll. Fehlende Quantisierungs- oder Build-Angaben sind ausdrücklich markiert. Für Qwen 2.5 ohne Coder-Zusatz sowie 14B/405B sind hier keine passenden Spark-Messungen belegt; Werte anderer Modelle werden nicht übertragen. Diese Tabelle bleibt unabhängig von der Konfigurations- und Modellauswahl im Speicher-Labor.
Testsysteme, Methodik und Grenzen
04 / DIE ENTSCHEIDUNG
5090 für Tempo. Spark für CUDA mit viel Speicher. Studio für mehr Spielraum.
Die Kapazitätsstufen sind klar: 32 GB dedizierter VRAM → 128 GB Unified Memory → 256 GB Unified Memory. Daraus folgt keine feste Reihenfolge bei der LLM-Geschwindigkeit. Entscheidend ist der gesamte Bedarf aus Gewichten, KV-Cache und Laufzeit – nicht allein die Parameterzahl.
RTX 5090 · 32 GB VRAM
Wenn es passt: viel Tempo.
Für vollständig im VRAM laufende CUDA-Workloads bleibt die RTX 5090 eine schnelle Wahl, besonders für ComfyUI. Das Labor setzt nach Reserve 30 GB GPU-Budget an. Größere Modelle benötigen Offloading; beim Referenz-PC mit 32 GB RAM ist auch dessen Spielraum begrenzt.
Bis etwa 30 GB Bedarf: 5090 zuerst prüfen.DGX SPARK / PGX · 128 GB
Große Modelle. CUDA bleibt.
32GB VRAM→128GB UNIFIED
GB10 schließt eine Kapazitätslücke: 112 GB angesetztes GPU-Budget ohne PCIe-Offloading in getrennten CPU-RAM. Besonders interessant für CUDA-Entwicklung und MoE-Modelle. Die 273 GB/s Speicherbandbreite begrenzen große dichte LLMs bei der Token-Erzeugung.
Beispiele aus getrennten Tests: gpt-oss-120B MXFP4 erreicht 58,72 Tokens/s bei d0; Llama 3.3 70B im Ollama-Coding-Lauf 4,67 Tokens/s. Die Parameterzahl allein erklärt das Tempo nicht.
Zwischen 30 und 112 GB: Spark und Mac am konkreten Modell vergleichen.MAC STUDIO · BIS 256 GB AUSWÄHLBAR
Mehr Kapazität. Auch vorher relevant.
128GB SPARK→256GB STUDIO
Oberhalb des Spark-Budgets bietet ein 256-GB-Studio mehr Platz: bei der voreingestellten 75-%-Annahme 192 GB GPU-Budget. Die 256-GB-Variante ist der größte aktuell bestätigte Ausbau auf dieser Seite. In der Rechnerkarte von 96 auf 256 GB umstellen.
Macs sind auch unter 128 GB eine Alternative. Höhere Speicherbandbreite kann die Einzelstrom-Generation dichter Modelle begünstigen; Metal-/MLX-Unterstützung und konkrete Messwerte bleiben entscheidend. CUDA-only-Workflows benötigen einen passenden anderen Pfad.
Über 112 GB Budgetbedarf: 256-GB-Studio prüfen; über 192 GB reicht die Standardannahme auch dort nicht.
Gesamter Modellbedarf
Einordnung mit den Standardreserven
Bis 30 GB
RTX 5090 als schnelle CUDA-Referenz. Spark und Mac können ebenfalls passen.
Über 30 bis 112 GB
DGX Spark / PGX und ausreichend ausgestattete Macs. Auswahl nach Modell, Quantisierung, Prefill, Generation und Backend; kein pauschaler Spark-Vorsprung.
Über 112 bis 192 GB
Spark überschreitet das angesetzte Budget. Mac Studio mit 256 GB bietet bei 75 % GPU-Anteil genügend Kapazität.
Über 192 GB
Auch das 256-GB-Studio passt bei den Standardannahmen nicht vollständig. Quantisierung, Kontext oder Hardwarestrategie anpassen.
Fazit zur These: Als Speicherstaffel ist „5090 → Spark → 256-GB-Studio“ hilfreich. Als Geschwindigkeitsrangfolge ist sie nicht belegt. Der Wechsel zum Mac beginnt nicht erst bei exakt 128 GB: Betriebssystem und Laufzeit brauchen Reserve; bei dichten LLMs kann ein Mac schon vorher die bessere Wahl sein. Für belastbare Kaufentscheidungen dieselben Modelle, Quantisierungen und Kontexte im selben Protokoll messen. Messwerte und Originalquellen ↑
Veröffentlichte Messreihen sind im Benchmark-Bereich mit Originalkonfiguration und Quelle hinterlegt. Die eigenen Messfelder bleiben davon unabhängig.
Preise & Aktualisierung
Für 124 auswählbare Konfigurationen wurden die Endpreise direkt aus dem deutschen Apple-Konfigurator abgerufen. Jede Antwort wurde auf die tatsächlich zurückgegebenen Chip-, RAM-, SSD- und Ethernet-Werte geprüft. Bei 512 GB RAM lieferte Apple abweichend 96 GB zurück; diese Kombinationen sind deaktiviert und erhalten keinen falschen Preis. Verbindlich ist der Preis im Apple-Konfigurator. Geizhals ist als externer Preisvergleich verlinkt. Für Spark sind zusätzlich zwei vom Nutzer vorgegebene Händler-Preisreferenzen vom 27.10.2026 hinterlegt: Founders Edition mit 4 TB für 7.500 € (Joybuy) und Lenovo ThinkStation PGX mit 1 TB für 5.869 € (easynotebooks). Joybuy lieferte beim Abruf eine 403-Sperre; easynotebooks war nicht abrufbar. Preis, Verfügbarkeit, Versand und Steuerangaben wurden daher nicht unabhängig bestätigt. Die Angebote sind direkt in der Spark-Karte verlinkt.
Die Mac-Preisanzeige nutzt die hinterlegten Apple-Daten; die Spark-Preisreferenzen sind separat mit ihrer Herkunft gekennzeichnet. Früher manuell gespeicherte Preise beeinflussen die Anzeige nicht. Konfigurationen und eigene Performance-Messungen bleiben lokal in diesem Browser. Eine lokale Datei kann Apple und Geizhals wegen Zugriffsschutz und Browserbeschränkungen nicht verlässlich live auslesen.
Danach die Seite neu laden. Benötigt Internet und Python 3. Ruft jede Kombination direkt bei Apple ab und aktualisiert Endpreise sowie Abrufdatum. Bei einem Abruffehler bleiben die bisherigen Preise erhalten. Für die veröffentlichte Website die aktualisierten Dateien auf GitHub hochladen.